ОБЗОР AI-МОДЕЛИ
Qwen3.8-27B
Возможности, стоимость и компьютер для локального запуска
Разбор Qwen3.8-27B: возможности, бенчмарки, API, память для Q4/Q8/BF16 и компьютеры для запуска — Mac Studio, RTX 5090 и DGX Spark.
- Разработчик
- Alibaba · Qwen
- Параметры
- 27 млрд — языковая часть; vision encoder отдельно
- Лицензия
- Apache 2.0
- Вход → выход
- Вход: текст, изображения, видео. Выход: текст
- Контекст
- 262 144 нативно; расширение до 1 млн при поддержке runtime; QwenCloud — 1 млн
- API · вход / выход
- QwenCloud: $0,50 вход / $3,00 выход за 1 млн токенов; 10.09.2026
На этой странице
Кому подходит
Где стоит попробовать модель
Код и отладкаСтоит попробовать
Разработчики заявляют улучшения в программировании. Стоит проверить на задачах своего проекта.
Что проверить: Запуск, тесты, крайние случаи и безопасность изменений.
Основание оценки ↗Документы и анализСтоит попробовать
Модель можно попробовать для извлечения данных и подготовки выводов по материалам.
Что проверить: Точность чисел, ссылки на исходный текст и отсутствие выдуманных фактов.
Основание оценки ↗Изображения и видеоС условиями
Поддерживается понимание визуального входа. Нужны совместимый runtime и мультимодальные компоненты.
Что проверить: Загружен ли vision projector, корректно ли прочитан текст на изображении.
Основание оценки ↗Агенты и инструментыС условиями
Работа с инструментами требует настроенной среды исполнения.
Что проверить: Формат вызовов, аргументы, обработку ошибок и разрешения на действия.
Основание оценки ↗Сравнить с другой моделью
Qwen3.8-27B — открытая модель Alibaba для работы с текстом, кодом, изображениями и видео. Эта страница посвящена конкретному checkpoint Qwen/Qwen3.8-27B. Дата проверки материалов — 10 сентября 2026 года.
Выбор для локального запуска: начните с Q4 и короткого контекста. Практический ориентир — 32 ГБ системной памяти для экспериментов на CPU, 24–32 ГБ видеопамяти для GPU или 64 ГБ объединённой памяти Mac для запаса. Это расчётные рекомендации, а не результаты нашего тестового стенда.
Для первого внедрения полезнее проверить десять собственных документов и задач, чем покупать компьютер по месту модели в рейтинге. Успешная генерация одного ответа ещё не подтверждает приемлемую задержку, качество русского языка или устойчивую работу нескольких сотрудников.
Другие версии: что нельзя смешивать
| Вариант | Что важно при выборе |
|---|---|
| Qwen3.8-27B | Плотная мультимодальная модель; основной предмет этой статьи. Релиз 14 августа 2026 года. |
| Qwen3.8-2.4T-A95B | MoE: 2,4 трлн параметров, 95 млрд активных. Открытый checkpoint ориентирован на текст; это другой класс оборудования. |
| Qwen3.8-Flash-Next | Отдельная архитектура и отдельный релиз. Требования 27B на неё не распространяются. |
Даты сверены с репозиторием Qwen. Отличия крупной версии — в её карточке модели, Flash-Next — в анонсе разработчика. Для 2.4T даже идеализированное хранение всех весов в 4 битах даёт около 1,2 ТБ до накладных расходов: активные параметры не заменяют полный объём весов при расчёте памяти. Один Mac Studio или DGX Spark 128 ГБ для этого не подходит.
Качество и возможности
| Задача | Как использовать | Что проверять на своих данных |
|---|---|---|
| Документы и знания компании | Ответы с поиском по документам, извлечение полей | Ссылки на исходные фрагменты, пропуски и выдуманные факты |
| Программирование | Объяснение кода, исправления, подготовка тестов | Сборку, тесты и изменения поведения приложения |
| Изображения и видео | Разбор схем, страниц и кадров | Мелкий текст, порядок страниц, стоимость обработки кадров |
| Агенты и инструменты | Планирование и вызов подключённых функций | Валидность аргументов и реальные результаты каждого действия |
| Русскоязычный помощник | Проверка терминологии и инструкций на русском | Собственный набор вопросов: отдельного нашего RU-бенчмарка нет |
Модель выдаёт текст. Понимание изображения не означает генерацию изображений; просмотр видео не означает создание ролика. Браузер, поиск и исполнение кода нужно подключать в приложении. Для локальных файлов и внешних инструментов полезно заранее определить, какие действия требуют участия человека.
Thinking включён по умолчанию и допускает отключение; глубина рассуждения настраивается. Возможности и режимы описаны в официальной карточке 27B. Длинное рассуждение увеличивает задержку и расход токенов. Для извлечения короткого поля сначала сравните качество с reasoning и без него.
Результаты тестов
| Бенчмарк | Результат Qwen3.8-27B |
|---|---|
| GPQA Diamond | 89,2 |
| Humanity’s Last Exam | 30,8 |
| LiveCodeBench v6 | 90,3 |
| SWE-bench Pro | 61,7 |
| Terminal Bench 2.1, Terminus | 73,0 |
| OSWorld-Verified | 84,3 |
| OmniDocBench 1.5 | 91,1 |
| RealWorldQA | 85,9 |
Источник — таблицы Qwen. Это опубликованные авторами значения в шкалах соответствующих тестов, не наши измерения и не обещание той же точности в Q4. Результаты разных тестов нельзя усреднять в единый «процент интеллекта». Для SWE-bench Pro важны использованный агентный harness и исправленный набор заданий: сравнение с другой таблицей без совпадающей методики может вводить в заблуждение.
Независимые проверки
| Проверка | Что показано | Ограничение |
|---|---|---|
| Авторский набор из 50 рабочих задач | Локальная NVFP4: 46/50 успешных задач, средний балл 0,789 | Частный набор и автоматические судьи; не стандарт качества русского языка |
| Логическая задача на Mac | Правильный ответ; опубликованный фрагмент ниже | Один простой пример, thinking включён |
| Sakura Crossing | Открытый 3D-проект с локальной Qwen3.8-27B | Автор вручную проверял, исправлял и развивал код |
Это полезные независимые свидетельства, но они не заменяют испытание на ваших документах. Для русского языка и инструментов у нас пока нет воспроизводимого собственного набора результатов. Перед внедрением проверьте деловую переписку, извлечение реквизитов, терминологию, отказы при нехватке данных и корректность вызовов инструментов.
Русский язык: что пишут пользователи
Два публичных сообщения, проверены 10.09.2026. Это опыт отдельных авторов, не опрос и не оценка большинства пользователей. Ниже — пересказ, не дословные цитаты.
| Автор и сценарий | Наблюдение | Что ограничивает вывод |
|---|---|---|
| VotZeFuk · Reddit · русская речь | Жалуется на неудачный выбор слов и бессмысленные фразы; предпочитает русский текст Gemma. В уточнении прямо относит замечание к 3.8-27B, а не к 3.8 Next | Квантизация, настройки и примеры запросов не приведены. Это субъективная оценка стиля, не доказательство общего превосходства другой модели |
| «Поляков считает» · Telegram · DGX Spark, ускоренный запуск | При включении спекулятивного декодирования автор отмечает ухудшение результата на русском при выигрыше на коде и JSON. В том же сообщении пишет, что агент с Qwen3.8-27B подготовил таблицы для отчётности по маркировке рекламы примерно за 30 минут | Обсуждение в основном о скорости: слово «деградация» здесь нельзя автоматически считать оценкой грамотности. Успешная отчётность — отдельный рабочий пример, а не проверка качества русской прозы |
Как использовать эти отзывы: отдельно проверять выполнение задачи и естественность русского текста. Для писем, статей и ответов клиентам полезна редакторская вычитка; удачная работа с кодом или таблицами сама по себе не подтверждает качество формулировок. Сопоставимых публичных примеров пока мало, поэтому общий рейтинг русского языка мы не выставляем.
Примеры и задачи для проверки
Опубликованные результаты, проекты авторов и тестовые запросы отмечены отдельно.
Логическая задача: опубликованный ответФрагмент опубликованного ответа
Задание в пересказе
Пять карточек A–E: E последняя, B сразу после A, D сразу после B, C раньше A. Определить позицию A. Это пересказ условий, не полный исходный промпт.
Фрагмент ответа из источника
ANSWER=2Источник и условия ↗
Разбор результата
Ответ верен: единственный порядок C–A–B–D–E. Мы проверили решение логически; локальный запуск не повторяли. Один простой пример не характеризует общий уровень рассуждений.
Sakura Crossing: настоящий 3D-проектПроект автора · с ручными доработками
Задание в пересказе
Интерактивный японский квартал: прогулка, железнодорожный переезд, автомобиль и река. Полный журнал промптов не опубликован.Источник и условия ↗ Открыть проект ↗
Разбор результата
При проверке 10.09.2026 стартовая кнопка открыла работающую 3D-сцену в Chrome. Полное прохождение, коллизии и FPS не проверялись. Это пример совместной работы человека и модели, не игра из одного запроса. Исходники доступны по GPL-3.0. При оценке проверьте управление, коллизии, камеру и производительность на телефоне; авторство каждого изменения по README установить нельзя.
Исправить ошибку в JavaScriptЗапрос для самостоятельной проверки
Запрос
Исправь функцию average(values):
function average(values) { return values.reduce((a, b) => a + b) / values.length; }

Требования: принимать только массив конечных чисел, для пустого массива возвращать null, для неверного типа или NaN бросать TypeError. Не меняй входной массив. Дай исправленную функцию, пояснение и тесты на node:assert/strict.
Как оценить результат
Запустите тесты отдельно. Проверьте [], [0], [-2, 2], [1.5, 2.5], [NaN], [Infinity], ["2"] и null. Тесты не должны просто повторять реализацию.
Извлечь данные без домысловЗапрос для самостоятельной проверки
Запрос
Верни только JSON с полями invoice_number, date, total_rub, supplier_inn. Если поле не указано, используй null.

Документ: Счёт A-104 от 10.09.2026. Поставщик: ООО «Пример». Разработка: 40 000 руб.; проверка: 10 000 руб. Итого: 50 000 руб. Реквизиты будут предоставлены отдельно.
Как оценить результат
Проверьте валидность JSON, итог 50000 и null в supplier_inn. Модель не должна выдумывать ИНН. Дата должна однозначно соответствовать исходному документу.
Собрать прототип 3D-игрыЗапрос для самостоятельной проверки
Запрос
Создай небольшой прототип 3D-игры на Three.js: игрок собирает 5 кубов на плоскости. Управление WASD, камера следует за игроком, есть счётчик и перезапуск. Используй геометрические примитивы без внешних моделей. Укажи точную версию зависимости, структуру файлов и команды локального запуска. Скорость движения не должна зависеть от FPS. Объясни, как проверить столкновения и завершение игры.
Как оценить результат
Проверьте запуск по инструкции, ошибки консоли, управление, счётчик, перезапуск и одинаковую скорость движения при разной частоте кадров. Это упражнение на написание кода; готовый 3D-проект и его качество необходимо проверить вручную.
Локальный запуск
Запустится на вашем компьютере?
Подберём профиль по платформе и памяти. Показываем опубликованные измерения скорости вместе с условиями теста.
Это сопоставление с опубликованными профилями, а не диагностика устройства. Совместимость драйверов, версия runtime и реальные задержки требуют проверки.
Требования относятся к конкретному формату, контексту и среде. RAM, VRAM и общая память не взаимозаменяемы.
Размер файлов — только начало расчёта
| Файл из сборки ggml-org | Размер скачивания |
|---|---|
| Основная модель Q4_K_M | 19,0 ГБ |
| Основная модель Q8_0 | 28,6 ГБ |
| Основная модель BF16 | 53,8 ГБ |
| Vision projector Q8_0 | Дополнительно 629 МБ |
| Vision projector BF16 | Дополнительно 931 МБ |
Как рассчитать память: KV-кэш, буферы и запас
Размеры относятся к конкретным файлам ggml-org, в десятичных ГБ. Общий размер репозитория складывает альтернативные файлы: скачивать все варианты не нужно. У другого конвертера даже Q4_K_M может иметь иной размер. Дополнительные MTP-веса в этот бюджет не включены.
Бюджет памяти = веса + KV-кэш + состояния модели + рабочие буферы + запас для ОС. Для изображений добавляются encoder/projector и обработка входа. Системная RAM и VRAM дискретной карты — разные пулы. На Mac и Spark память общая, и её часть занимает система.
Для полного внимания этой конфигурации расчёт BF16 KV-кэша составляет примерно 64 КиБ на токен одной последовательности: 16 слоёв × 4 KV-головы × 256 × 2 × 2 байта. Это даёт около 0,5 ГиБ при 8 192 токенах, 2 ГиБ при 32 768 и 16 ГиБ при 262 144. Здесь не учтены состояния DeltaNet, дополнительные запросы и служебные буферы. Размеры и особенности recurrent-state pool разобраны в документации SGLang.
Скорость по опубликованным тестам
Это внешние измерения генерации, не наши испытания и не обещание скорости на любом компьютере с такой памятью.
| Оборудование и формат | Генерация | Условия / источник |
|---|---|---|
| RTX 5090 32 ГБ · GGUF Q4_K_M | 65,7 ток/с, медиана | 114 → 256 токенов, thinking выключен; llm-speed |
| DGX Spark 128 ГБ · FP8 | 8,2 ток/с | 2 048 → 128, один запрос, vLLM nightly; Saiyam Pathak |
| M5 Max 64 ГБ · MLX 8-bit | 18,1 ток/с без ускорения | Агрегированный результат автора; с DSpark: чат 28,8, код 36,5, математика 43,8; протокол |
У Mac не указан полный размер входа и форм-фактор компьютера. Это ориентир по чипу, не замер выбранного Mac Studio и не сопоставимый с RTX тест. Ускорение зависит от задачи. Для CPU-only подтверждённого результата этой точной модели не найдено; число не подставляем. В строках ниже измеренные профили отделены от расчётных.
Конфигурации, скорость и инструкции
CPU: практический стартGGUF Q4_K_M, ggml-org 19 ГБНет замера для этого профиляРасчётная оценка
- Квантизация
- GGUF Q4_K_M, ggml-org 19 ГБ
- Контекст
- 8 192
- Среда и версия
- Совместимая llama.cpp
- RAM
- 32 ГБ минимум для эксперимента; 64 ГБ с запасом
- VRAM
- Не требуется
- Объединённая память
- Не применяется
- Накопитель
- 40 ГБ свободно
- Одновременные запросы
- 1 запрос
- Скорость и единица
- Не измеряли; численная скорость не заявляется
- Условия теста / ограничения
- Текст, один пользователь; CPU 6–8 ядер — рекомендация, не абсолютный минимум. Не обещаем интерактивную скорость.
Скорость и условия измерения
- Генерация
- Нет замера для этого профиля
Инструкция запуска
Используйте сборку llama.cpp с поддержкой Qwen3.8. Для конвертации bartowski указан минимум b10419. Этот пример намеренно использует её собственный репозиторий; таблица размеров выше относится к ggml-org.
llama-server -hf bartowski/Qwen3.8-27B-GGUF:Q4_K_M \
  --ctx-size 8192 --host 127.0.0.1 --port 8080
После установки подходящей сборки откройте http://127.0.0.1:8080. При первом запуске скачиваются веса. Проверьте журнал: какой backend выбран, сколько слоёв размещено на GPU и загружен ли vision projector. Для CPU будет иной профиль скорости. Вручную скачанные мультимодальные файлы требуют корректного --mmproj; один языковой GGUF не обеспечивает обработку картинок.
GPU 24 ГБ: расчётный минимумGGUF Q4_K_MНет замера для этого профиляРасчётная оценка
- Квантизация
- GGUF Q4_K_M
- Контекст
- 8 192
- Среда и версия
- llama.cpp / CUDA
- RAM
- 32 ГБ минимум; рекомендуем 64 ГБ
- VRAM
- 24 ГБ, запас зависит от backend
- Объединённая память
- Не применяется
- Накопитель
- 40 ГБ свободно
- Одновременные запросы
- 1 запрос
- Скорость и единица
- Не измеряли; численная скорость не заявляется
- Условия теста / ограничения
- Текст без MTP; при vision или большом контексте проверить память, уменьшить контекст или offload.
Скорость и условия измерения
- Генерация
- Нет замера для этого профиля
Инструкция запуска
Используйте сборку llama.cpp с поддержкой Qwen3.8. Для конвертации bartowski указан минимум b10419. Этот пример намеренно использует её собственный репозиторий; таблица размеров выше относится к ggml-org.
llama-server -hf bartowski/Qwen3.8-27B-GGUF:Q4_K_M \
  --ctx-size 8192 --host 127.0.0.1 --port 8080
После установки подходящей сборки откройте http://127.0.0.1:8080. При первом запуске скачиваются веса. Проверьте журнал: какой backend выбран, сколько слоёв размещено на GPU и загружен ли vision projector. Для CPU будет иной профиль скорости. Вручную скачанные мультимодальные файлы требуют корректного --mmproj; один языковой GGUF не обеспечивает обработку картинок.
RTX 5090: подтверждённый рецептInferact NVFP4Нет замера для этого профиляПодтверждено источником
- Квантизация
- Inferact NVFP4
- Контекст
- 32 768
- Среда и версия
- vLLM 0.26.1rc1.dev608+g99a10304d
- RAM
- Рекомендуем 64 ГБ
- VRAM
- 32 ГБ
- Объединённая память
- Не применяется
- Накопитель
- Рекомендуем 60 ГБ свободно
- Одновременные запросы
- 1 запрос
- Скорость и единица
- Не измеряли; численная скорость не заявляется
- Условия теста / ограничения
- Подтверждение авторов vLLM для GPU, не нашего готового ПК. --enforce-eager, KV fp8; текстовый serving.
Скорость и условия измерения
- Генерация
- Нет замера для этого профиля
Инструкция запуска
Официальный рецепт vLLM проверен на версии 0.26.1rc1.dev608+g99a10304d; требуется Transformers ≥ 5.8.0. Для одной RTX 5090 приведён следующий вариант:
vllm serve Inferact/Qwen3.8-27B-NVFP4 \
  --tensor-parallel-size 1 \
  --max-model-len 32768 \
  --kv-cache-dtype fp8 \
  --enforce-eager \
  --reasoning-parser qwen3 \
  --host 127.0.0.1
--enforce-eager отключает CUDA graphs: без него авторы рецепта получили нехватку памяти при старте. Это подтверждение текстового serving на указанной связке, а не универсальный тест всех мультимодальных режимов. Используйте совместимое Linux-окружение с драйвером NVIDIA; предустановленная Windows на готовом ПК сама по себе не означает готовность vLLM.
Mac Studio: запас под Q4/Q8GGUF Q4_K_M или Q8_0Нет замера для этого профиляРасчётная оценка
- Квантизация
- GGUF Q4_K_M или Q8_0
- Контекст
- Начать с 8 192
- Среда и версия
- Совместимая llama.cpp / Metal
- RAM
- Общая с GPU
- VRAM
- Отдельной нет
- Объединённая память
- 64 ГБ рекомендуем
- Накопитель
- 60 ГБ свободно для Q8
- Одновременные запросы
- 1 запрос
- Скорость и единица
- Не измеряли; численная скорость не заявляется
- Условия теста / ограничения
- Оценка объёма; M5 Max в предзаказе, работу точного runtime на новом чипе и скорость не тестировали.
Скорость и условия измерения
- Генерация
- Нет замера для этого профиля
Инструкция запуска
Используйте сборку llama.cpp с поддержкой Qwen3.8. Для конвертации bartowski указан минимум b10419. Этот пример намеренно использует её собственный репозиторий; таблица размеров выше относится к ggml-org.
llama-server -hf bartowski/Qwen3.8-27B-GGUF:Q4_K_M \
  --ctx-size 8192 --host 127.0.0.1 --port 8080
После установки подходящей сборки откройте http://127.0.0.1:8080. При первом запуске скачиваются веса. Проверьте журнал: какой backend выбран, сколько слоёв размещено на GPU и загружен ли vision projector. Для CPU будет иной профиль скорости. Вручную скачанные мультимодальные файлы требуют корректного --mmproj; один языковой GGUF не обеспечивает обработку картинок.
DGX Spark: BF16 и короткий контекстBF16Нет замера для этого профиляПодтверждено источником
- Квантизация
- BF16
- Контекст
- 8 192 вход / 1 024 выход
- Среда и версия
- SGLang; рецепт commit 1cf2b8c54d81802abc15dcf23a29b9cc687bc01e
- RAM
- Общая с GPU
- VRAM
- Отдельной нет
- Объединённая память
- 128 ГБ установленной памяти
- Накопитель
- 100 ГБ свободно рекомендуем
- Одновременные запросы
- 1 запрос
- Скорость и единица
- Не измеряли; численная скорость не заявляется
- Условия теста / ограничения
- SGLang подтвердил boot-and-serve; throughput не опубликован. Диск — наша рекомендация. Не переносить результат на контекст 1 млн.
Скорость и условия измерения
- Генерация
- Нет замера для этого профиля
RTX 5090 · Q4_K_M · внешний тестGGUF Q4_K_MВнешний тест: 65.4–65.7 ток/сПамять: оценка
- Квантизация
- GGUF Q4_K_M
- Контекст
- 16 384 настроено; тест 114 вход / 256 выход
- Среда и версия
- llama.cpp 9725a31 · CUDA
- RAM
- 32 ГБ минимум; у автора 30 ГБ доступны WSL
- VRAM
- 32 ГБ RTX 5090
- Объединённая память
- Не применяется
- Накопитель
- 40 ГБ свободно — расчётный запас
- Одновременные запросы
- 1
- Скорость и единица
- Внешний тест: 65,4–65,7 ток/с; полные условия ниже
- Условия теста / ограничения
- Измерение на Ryzen 7 9850X3D, не на готовом CORSAIR. Требования памяти/диска для подбора — оценка.
Скорость и условия измерения
- Генерация
- Внешний тест: 65.4–65.7 ток/с
- Время до первого токена, с
- 0.1175
- Вход в измерении, токенов
- 114
- Выход в измерении, токенов
- 256
- Размещение на GPU / offload
- 65/65 слоёв на GPU
- Условия измерения
- 3 повтора; медиана 65,7. Модель прогрета, thinking/cache выключены, temperature 0, seed 42. Артефакт 0669b98607d47046c7c2b3f801011d54a08cfccf. Клиент llm-speed 0.0.5 с описанными автором исправлениями.
- Основание
- Внешнее измерение
Инструкция запуска
Настройки сервера и результаты повторов: протокол автора. Число относится только к указанному Q4-профилю; NVFP4 — другой запуск.
DGX Spark · FP8 · внешний тестQwen/Qwen3.8-27B-FP8 · 017b9c7aВнешний тест: 8.2 ток/сПамять: оценка
- Квантизация
- Qwen/Qwen3.8-27B-FP8 · 017b9c7a
- Контекст
- 2 048 вход / 128 выход; depth 0
- Среда и версия
- vLLM spark-arena nightly 0.27.2rc1
- RAM
- Общая с GPU
- VRAM
- Отдельной нет
- Объединённая память
- 128 ГБ установленной памяти
- Накопитель
- 100 ГБ свободно рекомендуем
- Одновременные запросы
- 1
- Скорость и единица
- Внешний тест: 8,2 ток/с; полные условия ниже
- Условия теста / ограничения
- DGX Spark GB10 128 ГБ. Запас памяти/диска в подборе — консервативная оценка, не минимальный измеренный порог.
Скорость и условия измерения
- Генерация
- Внешний тест: 8.2 ток/с
- Вход в измерении, токенов
- 2048
- Выход в измерении, токенов
- 128
- Размещение на GPU / offload
- GB10 · объединённая память
- Условия измерения
- llama-benchy 0.4.0; один запрос, depth 0. DGX OS, driver 580.159.03. Это скорость генерации на FP8, не BF16 и не суммарная пропускная способность нескольких пользователей.
- Основание
- Внешнее измерение
Инструкция запуска
Команды и таблица автора. Не переносите скорость на профиль BF16/SGLang.
Дополнительные сценарии и запас памяти
Все оценки ниже предполагают одного пользователя, текстовый запрос и отключённое дополнительное speculative decoding.
| Сценарий | Память | Контекст для старта | Статус рекомендации |
|---|---|---|---|
| CPU, Q4_K_M | 32 ГБ RAM; современный CPU 6–8 ядер как ориентир | 8 192 | Расчётный минимум для эксперимента; скорость не измерена |
| Дискретная GPU, Q4_K_M | 24 ГБ VRAM + 32 ГБ RAM; лучше 64 ГБ RAM | 8 192 | Оценка; запас зависит от runtime и vision |
| RTX 5090, NVFP4 | 32 ГБ VRAM + рекомендуемые 64 ГБ RAM | 32 768 | Запуск подтверждён авторами рецепта vLLM с особыми флагами |
| Apple Silicon, Q4 | От 32–36 ГБ unified для коротких запросов; рекомендуем 64 ГБ | 8 192 | Оценка памяти; точную связку ОС и runtime нужно проверить |
| Q8 на машине с общей памятью | Рекомендуем 64 ГБ unified | 8 192–32 768 | Оценка, без гарантии скорости |
| BF16 на машине с общей памятью | Рекомендуем 96–128 ГБ unified | Начать с 8 192 | Оценка запаса; Spark отдельно проверялся проектом SGLang |
Для Q4 оставьте минимум 40 ГБ свободного SSD, для Q8 — 60 ГБ, для BF16 — 100 ГБ. Это наш запас на загрузку, временные файлы и служебные данные, а не размер весов. Для нескольких форматов и документов удобнее SSD от 1 ТБ.
16 ГБ VRAM недостаточно для полного размещения выбранного 19-ГБ Q4-файла. Частичная выгрузка на CPU возможна при достаточной RAM, но требует отдельной проверки задержек. Контекст 1 млн не следует выбирать по умолчанию: сначала измерьте короткий запрос, затем увеличивайте длину и число одновременных обращений.
Готовые компьютеры
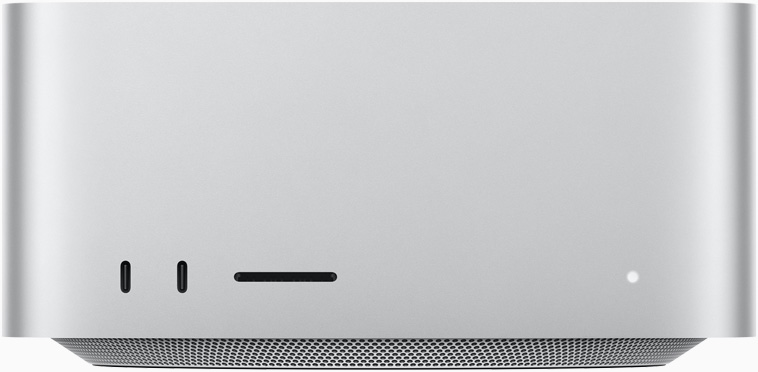
РАБОЧЕЕ МЕСТО НА macOS
Mac Studio M5 Max
64 ГБ памяти для Q4/Q8. Предзаказ: доступность с 22 сентября. Скорость на этой конфигурации не измеряли.
- Графика
- Встроенный Apple GPU, 40 ядер
- Общая память
- 64 ГБ; часть занимает ОС
- SSD
- SSD 1 ТБ
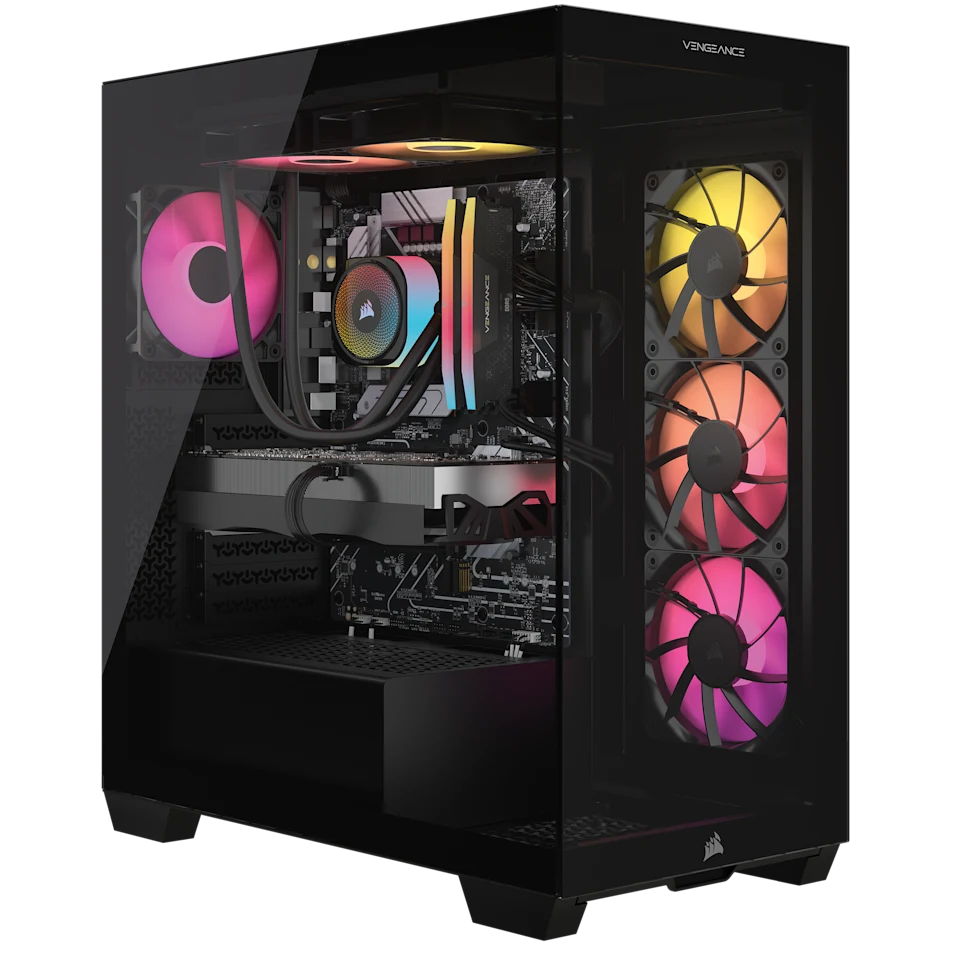
CUDA И ЛОКАЛЬНЫЙ API
CORSAIR VENGEANCE a7500
RTX 5090 с 32 ГБ VRAM для NVFP4. Для рецепта vLLM понадобится совместимое Linux-окружение.
- Графика
- NVIDIA GeForce RTX 5090, настольная
- RAM
- 64 ГБ DDR5
- SSD
- 4 ТБ, два M.2 SSD по 2 ТБ
КОМПАКТНАЯ AI-СТАНЦИЯ
NVIDIA DGX Spark
128 ГБ общей памяти и DGX OS. Для Qwen3.8 FP8 опубликован внешний тест 8,2 ток/с; условия — в обзоре. Ноутбук на фото не входит в комплект.
- Графика
- Blackwell в GB10 Grace Blackwell
- Общая память
- 128 ГБ LPDDR5x; 273 ГБ/с
- SSD
- 4 ТБ NVMe M.2
Фото: производители. Дополнительное оборудование на фото не входит в указанную конфигурацию.
Покупка и наличие
Проверено 10.09.2026. Цены относятся к указанным продавцам и комплектациям; доставка, импорт, налоги и гарантия в РФ требуют отдельного расчёта.
| Компьютер | Цена / регион | Наличие и покупка в РФ |
|---|---|---|
| Mac Studio M5 Max · 18 CPU / 40 GPU · 64 ГБ / 1 ТБ | $3 799, США, Adorama, Z1U4000JJ | Предзаказ; Apple указывает доступность с 22 сентября. Российская цена этой точной версии не подтверждена |
| CORSAIR VENGEANCE a7500 · 9900X3D / RTX 5090 / 64 ГБ | $6 699,99, США, CORSAIR | У производителя есть в наличии; поставка и цена в РФ не подтверждены |
| NVIDIA DGX Spark · 128 ГБ / 4 ТБ | 726 900 ₽, РФ, ONPAD | Продавец указывает «под заказ от 10 дней»; это не подтверждение складского остатка |
До оплаты запросите точный артикул, окончательную сумму, срок, гарантийное обслуживание и документы для бухгалтерии. Российское предложение Spark — найденная карточка продавца, не проверка его надёжности.
Как выбирать оборудование и проверять цены
| Компьютер и точная конфигурация | Для чего рассматривать | Ограничение |
|---|---|---|
| Mac Studio M5 Max, 18 CPU / 40 GPU, 64 ГБ, SSD 1 ТБ | Рабочее место на macOS; Q4/Q8 с запасом общей памяти | На дату статьи предзаказ, старт продаж 22 сентября; собственных тестов нет |
| CORSAIR VENGEANCE a7500, Ryzen 9 9900X3D, RTX 5090 32 ГБ, RAM 64 ГБ, SSD 4 ТБ | CUDA и локальный API; NVFP4 по рецепту vLLM | Для серверного стека потребуется настройка Linux; не BF16 целиком в GPU |
| NVIDIA DGX Spark, GB10, 128 ГБ unified, SSD 4 ТБ | Компактная Linux-машина с большим объёмом общей памяти | SGLang подтвердил запуск, но не опубликовал для этой проверки throughput |
Это подбор по памяти, программной совместимости и сценарию, а не рейтинг скорости. Переход с Q4 на BF16 не оправдывает покупку сам по себе: сначала сравните ответы на своём наборе задач. Ссылки на отдельные карточки конфигураций находятся ниже.
Mac: официальная конфигурация и дата доступности. ПК: спецификация CORSAIR. Spark: характеристики NVIDIA и US-магазин: $4 699. Цены точных конфигураций и найденное предложение в РФ приведены в таблице «Покупка и наличие» выше.
API и стоимость
| QwenCloud, USD за 1 млн токенов | Тариф на 10.09.2026 |
|---|---|
| Обычный вход | $0,50 |
| Выход | $3,00 |
| Вход с implicit cache | $0,10 |
| Создание explicit cache | $0,625 |
| Чтение explicit cache | $0,05 |
Идентификатор API — qwen3.8-27b, совместимый endpoint — https://dashscope-intl.aliyuncs.com/compatible-mode/v1. В текущей карточке QwenCloud указаны контекст 1 млн, максимальный финальный вывод 131K и reasoning-бюджет 262K. Лимиты конкретного запроса нужно сверять с режимом и входом; это не гарантии для локального GGUF.
Пример расчёта: 1 млн обычных входных и 100 тыс. оплачиваемых выходных токенов стоят $0,80 без дополнительных инструментов и налогов. Итог зависит от reasoning и правил тарификации. Локальный запуск не имеет платы за токен со стороны владельца весов, но требует оборудования, электричества и сопровождения. Доступность аккаунта, оплаты и поставки в России здесь не проверялась; долларовые цены не являются российским предложением.
Подходит ли российской компании?
Кандидат для локального пилота в российской компании — да, с условиями. Модель с открытыми весами позволяет организовать обработку на собственном сервере в РФ. Это удобно для внутренних документов и кода, но соответствие закону определяется всей системой, составом данных и процессами компании. Сам по себе локальный запуск не означает соответствия 152-ФЗ.
Где будут обрабатываться данные
| Сценарий | Практический вывод |
|---|---|
| Изолированный сервер в РФ, публичные или синтетические данные | Подходящий первый пилот; проверить качество, нагрузку и права на материалы |
| Данные сотрудников, клиентов, договоры | Нужны правовое основание, ограничения доступа, сроки хранения и меры защиты |
| Локальная модель, но облачные OCR, embeddings, логи или резервные копии | Часть данных всё равно может покидать инфраструктуру; проверить каждый сервис |
| Сервер компании за пределами РФ | Слово «локальный» не подтверждает выполнение требований локализации |
Проследите путь: запрос → файлы/OCR → поиск/RAG → модель → ответ → журналы → резервные копии. Проверьте телеметрию, удалённый доступ подрядчиков и автоматический переход на облачный API. Отключите ненужный исходящий трафик и подтвердите результат сетевым тестом.
Российское законодательство: что учесть
Обзор на 10.09.2026, не юридическое заключение. Схему обработки должен проверить ответственный за персональные данные и юрист. 152-ФЗ на сайте Минтруда; актуальная редакция.
| Требование | Что учесть в AI-системе |
|---|---|
| Цель и основание · ст. 5–6 | Определить цель, законное основание, минимальный состав данных и сроки удаления. Согласие — не единственное возможное основание |
| Локализация · ст. 18 ч. 5 | При сборе ПДн граждан РФ перечисленные в законе операции нельзя выполнять с базами за рубежом, кроме предусмотренных исключений. Сервер в РФ помогает выполнить эту часть требований |
| Уведомление · ст. 22 | До обработки проверить обязанность уведомить Роскомнадзор и актуальность сведений. Офлайн-LLM не превращает обработку в неавтоматизированную |
| Защита · ст. 19 | Организационные и технические меры под угрозы системы: доступ, учёт действий, защита хранилищ, контроль инцидентов |
| Передача за рубеж · ст. 12 | Облачный сервис или доступ иностранного получателя требуют отдельной оценки трансграничной передачи и предусмотренного уведомления |
| Решения о людях · ст. 16 | Не поручать модели самостоятельно решения с юридическими последствиями без проверки специальных оснований закона |
Apache 2.0 допускает коммерческое использование при соблюдении условий лицензии. Это не сертификат безопасности и не подтверждение включения решения в реестр российского ПО. Для специальных категорий данных, биометрии, КИИ и государственного сектора нужна отдельная проверка применимых требований.
Что проверить до рабочего запуска
- Начать с обезличенных или синтетических примеров; проверить, исключает ли обезличивание обратную идентификацию.
- Собрать 30–50 типичных русскоязычных задач с эталонами: договоры, реквизиты, инструкции, код. Это предлагаемый план, а не уже проведённый тест.
- Отдельно измерить ошибки фактов, выдуманные ссылки, пропуски, качество русского языка и верность JSON/вызовов инструментов.
- Ограничить инструменты и права агента; действия с последствиями отправлять ответственному сотруднику на проверку.
- Испытать утечки через RAG и prompt injection, разграничение доступа, удаление из индекса, журналов и резервных копий.
- Измерить TTFT, ток/с и задержку при реальном числе сотрудников. Зафиксировать модель, квантизацию, версии ПО и условия приёмки.
Пилот можно считать успешным после согласованной проверки качества, защиты данных и эксплуатационных расходов — не после первого удачного ответа.
Технические характеристики
Паспорт модели · все 18 параметров
| Разработчик | Alibaba · Qwen |
|---|---|
| Точная версия | Qwen/Qwen3.8-27B |
| Тип модели | Мультимодальная |
| Доступность весов | Открытые веса; локальный запуск |
| Лицензия | Apache 2.0 |
| Всего параметров | 27 млрд — языковая часть; vision encoder отдельно |
| Активных параметров (MoE) | Плотная модель: нет выбора подмножества MoE-экспертов |
| Архитектура | 64 слоя: 48 Gated DeltaNet + 16 полного внимания; vision encoder |
| Контекстное окно | 262 144 нативно; расширение до 1 млн при поддержке runtime; QwenCloud — 1 млн |
| Максимальный вывод | Локально — в пределах выделенного контекста и runtime; QwenCloud: финал до 131K, reasoning до 262K |
| Модальности | Вход: текст, изображения, видео. Выход: текст |
| Работа с инструментами | Да, через приложение и совместимый parser; инструменты подключаются отдельно |
| Цена API и единица тарификации | QwenCloud: $0,50 вход / $3,00 выход за 1 млн токенов; 10.09.2026 |
| Подписка | Веса без подписки; API оплачивается по использованию |
| Дата выпуска | 14.08.2026 |
| Форматы весов | Оригинал BF16 / Safetensors; GGUF Q4/Q8; runtime-сборки NVFP4 |
| Среды запуска | Transformers ≥ 5.8.0; совместимые vLLM, SGLang, llama.cpp (для bartowski ≥ b10419) |
| Региональная доступность | Hugging Face / ModelScope; QwenCloud API. Доступность оплаты в РФ не проверена |
Устройство модели · архитектура
| Параметр конфигурации | Значение |
|---|---|
| Класс | Qwen3_5ForConditionalGeneration |
| Слои | 64: 48 Gated DeltaNet и 16 полного внимания |
| Hidden size / intermediate size | 5 120 / 17 408 |
| Attention heads / KV heads | 24 / 4 для полного внимания |
| Head dimension | 256 для полного внимания |
| Словарь | 248 320 |
| Исходная точность | BF16 |
| Нативный предел позиции | 262 144 токена |
| Vision encoder | 27 слоёв; hidden size 1 152 |
Значения взяты из config.json. Идентификатор qwen3_5 обозначает семейство реализации архитектуры: он не означает, что вы скачали другую версию. Плотная архитектура не имеет отдельного малого набора активных экспертов, характерного для MoE.
Вопросы и источники
Qwen3.8-27B бесплатна и разрешена для коммерческого проекта?
Веса опубликованы под Apache 2.0. Лицензия предусматривает коммерческое использование при соблюдении её условий, включая необходимые уведомления. Платный API — отдельная услуга. Открытые веса не означают публикацию полного обучающего корпуса.
Будет ли работать без интернета?
После скачивания весов и зависимостей локальный inference может работать без облачного API. Поиск в интернете, внешние инструменты и обновления — отдельные подключения. Если важна автономность, проверьте её с отключённой сетью на всей цепочке обработки документов.
Почему нет обещания «токенов в секунду»?
Мы не измеряли эту модель на перечисленных компьютерах. Скорость зависит от формата, длины входа, обработки изображений, reasoning, кэша и числа пользователей. Для сравнения фиксируйте время до первого токена, скорость продолжения и пиковую память, а не только одну цифру из короткого запроса.
Что выбрать первым для компании?
Подготовьте контрольный набор реальных задач и эталонных ответов. Проверьте облачную или имеющуюся локальную конфигурацию, измерьте качество и задержки, затем оцените нужный объём оборудования. Для локального пилота начинайте с одного пользователя и 8K контекста; увеличивайте нагрузку после замеров.
Как поддерживается актуальность этой страницы?
Характеристики, deployment-профили и связанные компьютеры сохранены отдельно в AI Models и доступны автоматическому сравнению. Текст объясняет ограничения этих цифр. Дата проверки относится к источникам; она не означает проведение аппаратного теста. Неизвестные показатели явно отмечены, расчётные требования отделены от подтверждений разработчиков runtime.
Есть ли измеренная скорость?
Да: есть внешние тесты RTX 5090 Q4_K_M и DGX Spark FP8. Числа и условия — во вкладке «Локально». Для CPU и точной конфигурации Mac Studio полного замера нет.
Что изменилось относительно Qwen3.6?
Отдельное сравнение Qwen3.8-27B и Qwen3.6-27B.
Источники данных
- Qwen — релизыgithub.com
- Qwen3.8-27B — модель и бенчмаркиhuggingface.co
- Архитектура — config.jsonhuggingface.co
- Лицензия Apache 2.0huggingface.co
- GGUF — размеры файлов ggml-orghuggingface.co
- llama.cpp — сборка bartowskihuggingface.co
- vLLM — проверенные конфигурацииrecipes.vllm.ai
- SGLang — конфигурации и проверка Sparkdocs.sglang.io
- QwenCloud — API и ценыwww.qwencloud.com
- Внешний тест RTX 5090llm-speed.com
- DGX Spark — тест автораblog.kubesimplify.com
- M5 Max — протокол автораgithub.com
- Независимые рабочие задачиhabr.com
- Опубликованный ответ на Macnote.com
- Sakura Crossing — исходникиgithub.com
- 152-ФЗ — Минтрудmintrud.gov.ru
- 152-ФЗ — актуальная редакцияwww.consultant.ru
- Русский язык — отзыв VotZeFuk (Reddit)www.reddit.com
- Русский текст и бизнес-задача — Поляков (Telegram)t.me